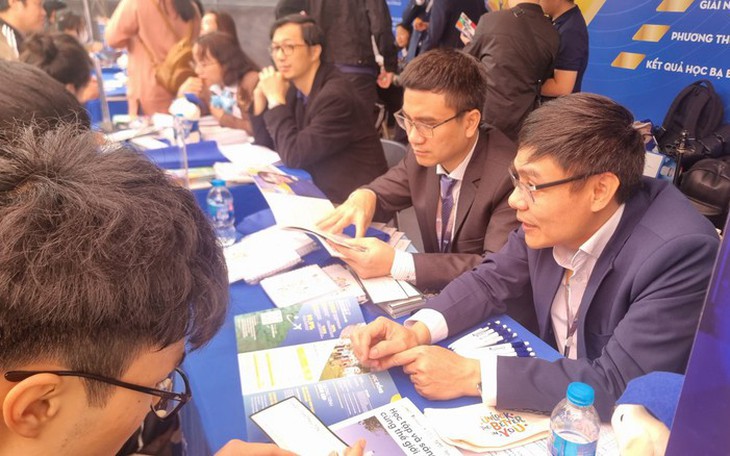
Ảnh minh họa. Nguồn: Baochinhphu.vn
Tóm tắt: Cá nhân hóa bằng trí tuệ nhân tạo (AI) có thể giúp trường đại học trả lời đúng nhu cầu thông tin của thí sinh và phụ huynh trong một quá trình lựa chọn nhiều giai đoạn. Tuy nhiên, việc thu thập, kết hợp và suy đoán dữ liệu để tạo thông điệp riêng cũng làm phát sinh rủi ro xâm phạm quyền riêng tư, thiên lệch thông tin và suy giảm niềm tin. Bài viết phân tích tài liệu nghiên cứu, số liệu tuyển sinh chính thức, quy định hiện hành về bảo vệ dữ liệu cá nhân và một số kết quả khảo sát 495 sinh viên tại hai trường đại học kỹ thuật – công nghệ. Khảo sát này phản ánh hành vi tiếp nhận truyền thông số và lựa chọn trường, chưa kiểm định tác động của AI. Trên cơ sở đó, bài viết đề xuất mô hình cá nhân hóa theo nhu cầu tự khai báo và nguồn dữ liệu tuyển sinh được xác thực; phân tầng rủi ro dữ liệu; thiết kế cơ chế lựa chọn, giải thích và chuyển tiếp cho người tư vấn; cùng bộ chỉ số đánh giá lợi ích thông tin, tính công bằng và niềm tin. Đóng góp của bài viết là chuyển trọng tâm từ tối đa hóa khả năng tiếp cận sang chất lượng phục vụ công chúng và trách nhiệm sử dụng dữ liệu trong tuyển sinh đại học.
Từ khóa: cá nhân hóa; AI tạo sinh; truyền thông tuyển sinh; dữ liệu cá nhân; niềm tin; giáo dục đại học.
AI PERSONALIZATION IN UNIVERSITY ADMISSIONS COMMUNICATION AND PROTECTION OF PROSPECTIVE STUDENTS DATA
Abstract: AI can help universities tailor admissions information to the needs of prospective students and parents across a multi-stage decision process. Yet collecting, combining and inferring personal data to produce tailored messages also creates privacy, fairness and trust concerns. This article synthesizes primary research, official admissions statistics, current Vietnamese personal data legislation and selected findings from an earlier survey of 495 students at two technology-oriented universities. The survey concerns digital communication and university choice, not the effect of AI. The paper proposes a need-declared personalization model grounded in verified admissions information, data-risk tiers, meaningful user choice and human escalation, and evaluation of informational benefit, fairness and institutional trust. Its contribution is to frame personalization as a public relationship and data-governance issue rather than simply a targeting technique.
Keywords: personalization; generative AI; admissions communication; personal data; trust; higher education.
1. Đặt vấn đề
Trong tuyển sinh đại học, thí sinh không cần cùng một thông điệp ở mọi thời điểm. Người mới tìm hiểu cần biết ngành học phù hợp với năng lực và sở thích; người đang so sánh trường cần thông tin về chương trình, học phí, học bổng, điều kiện xét tuyển và môi trường học tập; người chuẩn bị đăng ký cần hướng dẫn chính xác từng bước thao tác. Phụ huynh có thể quan tâm nhiều hơn đến chi phí và cơ hội nghề nghiệp. Cá nhân hóa truyền thông vì thế là khả năng tổ chức thông tin theo câu hỏi và giai đoạn quyết định của từng nhóm công chúng. AI tạo sinh mở rộng khả năng này bằng cách tóm tắt tài liệu, diễn đạt theo nhiều mức độ dễ hiểu, gợi ý thông tin liên quan và hỗ trợ đối thoại liên tục.
Tính cấp thiết của vấn đề không chỉ bắt nguồn từ công nghệ. Theo thống kê nhanh từ Bộ Giáo dục và Đào tạo công bố trên Báo Điện tử Chính phủ, tính đến 17 giờ ngày 28/7/2025 có 849.544 thí sinh đăng ký xét tuyển đại học, cao đẳng trên hệ thống chung với 7.615.560 nguyện vọng, trung bình 8,96 nguyện vọng mỗi thí sinh [2]. Số liệu bao gồm các cơ sở cao đẳng nghề nghiệp tham gia hệ thống và không thể coi là chỉ báo về việc sử dụng AI. Tuy vậy, số lượng lựa chọn lớn cho thấy nhu cầu so sánh thông tin theo hoàn cảnh riêng. Trường đại học phải giải thích một hệ thống điều kiện phức tạp cho nhiều nhóm công chúng trong thời gian hữu hạn, đồng thời bảo đảm một câu trả lời cá nhân hóa không làm sai lệch quy định hoặc tạo lời hứa khác với thông tin công khai.
Cá nhân hóa đặt ra sự đánh đổi. Thông tin càng sát nhu cầu, trường càng có xu hướng thu thập thêm dữ liệu: ngành quan tâm, lớp học, tỉnh cư trú, kết quả học tập, khả năng tài chính, lịch sử tương tác hoặc câu hỏi đã đặt cho chatbot. Không phải mọi dữ liệu ấy đều cần thiết. Nếu thí sinh chỉ hỏi học phí một chương trình, hệ thống không cần suy đoán thu nhập gia đình từ vị trí hay hành vi trực tuyến để trả lời. Một thông điệp quá "hiểu rõ" người nhận có thể gây khó chịu và cảm giác bị theo dõi, nhất là khi trường không nói rõ dữ liệu được lấy từ đâu và dùng vào việc gì. Nghiên cứu thực nghiệm ngoài lĩnh vực giáo dục cho thấy việc cung cấp thông tin cho AI thay vì con người có thể làm giảm niềm tin đối với thương hiệu trong một số điều kiện [7]. Điều này tạo một câu hỏi thực tiễn cho trường đại học: cá nhân hóa đến mức nào thì có ích, và ranh giới nào bảo vệ quyền kiểm soát của người học?
Từ ngày 01/01/2026, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 và Nghị định số 356/2025/NĐ-CP có hiệu lực [3, 4]. Đây là bối cảnh pháp lý trực tiếp cho các hoạt động thu thập, sử dụng và quản trị dữ liệu cá nhân trong tổ chức, bao gồm dữ liệu phục vụ tư vấn tuyển sinh. Bài viết không thay thế việc rà soát pháp lý từng hệ thống và phương án xử lý dữ liệu của một trường cụ thể. Ở góc độ quản trị truyền thông, nhà trường cần chứng minh được mục đích sử dụng dữ liệu, giới hạn cần thiết, người chịu trách nhiệm, khả năng giải thích và kênh để công chúng thực hiện lựa chọn của mình. UNESCO cũng nhấn mạnh cách tiếp cận lấy con người làm trung tâm, bảo vệ quyền riêng tư và xác thực công cụ AI trong giáo dục [5].
Bài viết tiếp cận vấn đề từ quan hệ tổ chức – công chúng. Niềm tin không đồng nhất với số lần nhấp vào quảng cáo; nó gắn với đánh giá về năng lực, tính chính trực và thiện chí của cơ sở giáo dục [6]. Một hệ thống tư vấn có thể đề xuất đúng ngành nhưng vẫn làm giảm thiện cảm nếu người dùng không biết dữ liệu của mình đã đi đâu. Ngược lại, dịch vụ cho phép tự chọn chủ đề, giải thích nguồn thông tin và chuyển sang cán bộ khi câu hỏi phức tạp có thể vừa hữu ích vừa tôn trọng công chúng. Mục tiêu của bài viết là phân tích hiện trạng và giới hạn của bằng chứng hiện có, rồi đưa ra một phương án cá nhân hóa có thể triển khai, kiểm tra và điều chỉnh tại các trường đại học Việt Nam.
Phương pháp nghiên cứu gồm tổng quan tài liệu có định hướng; phân tích khái niệm cá nhân hóa, lợi ích thông tin, quyền kiểm soát và niềm tin; đối chiếu số liệu chính thức với kết quả khảo sát trong một luận văn thạc sĩ về truyền thông số và quyết định chọn trường [1]; cuối cùng là suy luận ứng dụng để thiết kế giải pháp. Bài viết không có khảo sát mới về AI, không đo tỷ lệ trường đại học Việt Nam áp dụng cá nhân hóa và không đưa ra kết luận nhân quả về tác động của AI đến niềm tin. Những nhận định chuyển từ nghiên cứu thương mại sang tuyển sinh được nêu như gợi ý để thử nghiệm, không phải kết quả đã được xác nhận trong giáo dục đại học Việt Nam.
2. Hiện trạng nhu cầu cá nhân hóa và những giới hạn khi sử dụng dữ liệu
2.1. Nhu cầu thông tin khác nhau trên một hành trình lựa chọn nhiều kênh
Khảo sát 495 sinh viên tại Trường Đại học Điện lực và Đại học Công nghiệp Hà Nội cho thấy quá trình tiếp cận thông tin về trường diễn ra trên nhiều kênh [1]. Facebook nhận 364 lượt lựa chọn, website trường 220 lượt và TikTok 170 lượt, lần lượt chiếm 38,80%, 23,45% và 18,12% tổng lượt lựa chọn kênh. Đây là tỷ trọng trên tổng số lượt chọn, không phải tỷ lệ sinh viên sử dụng mỗi nền tảng hay số liệu đại diện toàn quốc. Kết quả cho thấy một người học có thể gặp thông điệp giới thiệu trên mạng xã hội, tiếp tục kiểm tra website, rồi hỏi thêm qua bình luận hoặc tư vấn trực tiếp. Cá nhân hóa hữu ích phải bảo đảm hành trình ấy liền mạch, không tạo những phiên bản thông tin mâu thuẫn.
Về định dạng, nghiên cứu ghi nhận 367 lượt lựa chọn bài viết thông tin (37,29% tổng lượt lựa chọn), 237 lượt chọn bình luận hoặc đánh giá của người dùng (24,08%) và 184 lượt chọn video ngắn (18,69%) [1]. Bài viết thông tin phục vụ tra cứu; nhận xét của người học hiện tại giúp đối chiếu kỳ vọng với trải nghiệm; video ngắn tạo điểm tiếp cận ban đầu. Không nên hiểu các tỷ lệ này là bằng chứng rằng thuật toán càng cá nhân hóa càng hiệu quả. Chúng gợi ý trường cần cung cấp cùng một dữ kiện dưới nhiều hình thức và dẫn công chúng từ nội dung ngắn về nguồn đầy đủ. Một học sinh hỏi về ngành kỹ thuật có thể nhận phần giải thích ngành phù hợp, nhưng vẫn cần thấy học phí, điều kiện đầu vào và nội dung chương trình chính thức giống với mọi người khác.
Mẫu khảo sát còn ghi nhận 28,1% sinh viên cho biết đã tiếp cận thông tin tuyển sinh 3–5 lần mỗi tuần, 21,6% tiếp cận hằng ngày và 14,9% nhiều lần trong ngày [1]. Dữ liệu mang tính hồi tưởng của người đã nhập học; mức độ chính xác của việc nhớ lại hành vi trước quyết định có giới hạn. Dù vậy, nó gợi mở rằng công chúng không nhận một thông điệp duy nhất rồi chọn trường. Họ tích lũy, đối chiếu và kiểm chứng qua nhiều lần tiếp xúc. Nếu hệ thống AI chỉ tối ưu nhấp chuột ở từng lần mà không nhớ câu hỏi đã giải đáp, không đồng bộ với thông tin chính thức hoặc liên tục nhắc lại nội dung không còn phù hợp, trải nghiệm cá nhân hóa trở thành phiền nhiễu.
Tính uy tín trong truyền thông số có mối liên hệ đáng chú ý với nhận thức và thái độ trong khảo sát. Ở các mô hình hồi quy, hệ số beta chuẩn hóa của yếu tố "uy tín" là 0,496 đối với nhận thức, 0,479 đối với thái độ và 0,298 đối với hành vi lựa chọn trường [1]. Tuy nhiên, bốn biến đầu vào của mô hình tương quan cao, với hệ số VIF từ 6,298 đến 9,840; dữ liệu cắt ngang và mẫu thuận tiện không cho phép suy luận nhân quả hay suy rộng toàn hệ thống. Bài học ứng dụng ở mức thận trọng là nội dung có ích cần đi cùng nguồn tin đáng tin cậy. Cá nhân hóa bằng AI không thể chỉ làm câu chữ gần gũi hơn mà bỏ qua việc xác thực dữ kiện, nhất quán giữa kênh và công khai người chịu trách nhiệm.
2.2. Từ phân nhóm công chúng đến cá nhân hóa bằng suy đoán
Cần phân biệt ba cấp độ cá nhân hóa. Cấp thứ nhất là tự lựa chọn: người dùng bấm vào ngành, địa điểm, hình thức học và câu hỏi họ quan tâm; trường trả nội dung đã công bố tương ứng. Cấp thứ hai là dựa trên thông tin người dùng chủ động cung cấp, chẳng hạn tình trạng đang học lớp 12, nhóm ngành dự định đăng ký hoặc nhu cầu được tư vấn học phí. Cấp thứ ba là suy đoán hồ sơ từ lịch sử duyệt web, tương tác mạng xã hội, vị trí, thiết bị và dữ liệu do bên thứ ba cung cấp. Khả năng cung cấp thông điệp "đúng người" tăng dần nhưng rủi ro vượt kỳ vọng của công chúng và tạo cảm giác bị theo dõi cũng tăng.
Trong môi trường giáo dục, mức độ phù hợp của thông tin không đồng nghĩa với quyền biết mọi điều về thí sinh. Từ việc một học sinh xem video về một ngành, trường không thể tự suy ra năng lực học tập, hoàn cảnh tài chính hay sở thích nghề nghiệp cố định. Nếu hệ thống chỉ quảng bá những chương trình mà thuật toán dự đoán có khả năng đăng ký cao, người học có thể không thấy lựa chọn phù hợp hơn nhưng ít được quảng cáo. Sai lệch còn xuất hiện khi dữ liệu cũ, hành vi của phụ huynh dùng chung thiết bị bị gán cho thí sinh, hoặc một nhóm vùng miền được tiếp cận ít thông tin học bổng hơn. Do đó, cá nhân hóa cần hỗ trợ tự chủ lựa chọn chứ không lặng lẽ thu hẹp không gian lựa chọn.
Nghiên cứu về quảng cáo cá nhân hóa bằng AI tại Việt Nam chỉ ra vai trò của mức độ liên quan, tính hữu ích và niềm tin trong phản ứng với quảng cáo [9]. Bằng chứng này có giá trị gợi mở về cơ chế tiếp nhận, nhưng đối tượng là người tiêu dùng, kết quả là ý định mua, không phải thí sinh và quyết định chọn trường. Nghiên cứu về cá nhân hóa trên mạng xã hội cũng xem xét đồng thời lợi ích, niềm tin và lo ngại quyền riêng tư [8]. Hai hướng nghiên cứu nhắc rằng hiệu quả trước mắt của một thông điệp được nhấp vào không đại diện đầy đủ cho chất lượng quan hệ lâu dài giữa trường với người học.
2.3. Rủi ro dữ liệu trong tư vấn tuyển sinh có AI tham gia
Một chuỗi dữ liệu điển hình bắt đầu từ biểu mẫu "nhận tư vấn": họ tên, điện thoại, lớp học, ngành quan tâm; sau đó là lịch sử mở thư, lượt nhấp, câu hỏi với chatbot và ghi chú của cán bộ tư vấn. Khi kết hợp lại, các mảnh thông tin có thể tạo hồ sơ chi tiết hơn nhiều so với điều người dùng nghĩ mình đã cung cấp. Nếu hồ sơ được đưa sang công cụ AI của bên ngoài để tóm tắt, phân nhóm hoặc dự báo khả năng đăng ký, trường phải xem xét luồng dữ liệu qua nhà cung cấp, quyền truy cập và thời hạn lưu. Dữ liệu một câu hỏi đơn lẻ có thể không nhạy cảm, nhưng lịch sử nhiều câu hỏi về điểm học tập, học phí và hỗ trợ tài chính có thể tiết lộ hoàn cảnh riêng của gia đình.
Một rủi ro khác là câu trả lời cá nhân hóa dựa trên dữ liệu đã lỗi thời. Quy chế tuyển sinh, mốc đăng ký hoặc chính sách học bổng có thể thay đổi giữa các đợt. AI tạo sinh có xu hướng diễn đạt tự tin kể cả khi thiếu nguồn. Một chatbot được thiết kế để "giữ chân khách hàng" có thể tránh trả lời "chưa biết", tự điền khoảng trống bằng suy đoán hoặc không phân biệt điều kiện áp dụng cho từng chương trình. Nếu người nhận thấy hai thí sinh được trả lời khác nhau về cùng một quy định, vấn đề không chỉ là lỗi kỹ thuật mà là uy tín và công bằng thông tin của trường.
Công chúng cũng có thể lo lắng về người nhận thông tin của mình. Nghiên cứu Lefkeli, Karataş và Gürhan-Canli trong bối cảnh thương hiệu cho thấy chia sẻ thông tin với AI thay vì con người có thể khiến người tham gia suy diễn rằng thông tin sẽ đến với một "công chúng" rộng hơn và cảm thấy bị khai thác, từ đó giảm niềm tin [7]. Đây không phải kết quả khảo sát ở Việt Nam. Trong tuyển sinh, một giải pháp thực dụng là giải thích AI xử lý khâu nào, ai có quyền xem cuộc trò chuyện, khi nào dữ liệu bị xóa và làm sao để chuyển sang người tư vấn. Trải nghiệm của công chúng được tạo bởi cách tổ chức quản trị, không chỉ bởi mô hình AI.
2.4. Khung pháp lý mới và khoảng trống thực thi tại cơ sở giáo dục
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 được ban hành ngày 26/6/2025 và có hiệu lực từ 01/01/2026; Nghị định 356/2025/NĐ-CP quy định chi tiết một số điều và biện pháp thi hành, cùng có hiệu lực ngày 01/01/2026 [3, 4]. Sự thay đổi này khiến mọi dự án tự động hóa tiếp cận thí sinh cần được rà soát theo quy trình tuân thủ hiện hành của trường. Bài viết không liệt kê thay cho các nghĩa vụ pháp lý cụ thể theo từng vai trò xử lý, loại dữ liệu và dòng chuyển dữ liệu. Về mặt quản trị, trường cần xác định rõ mục đích từng biểu mẫu, nguồn dữ liệu, người được truy cập, việc chia sẻ với nhà cung cấp, thời hạn giữ và cơ chế tiếp nhận yêu cầu của chủ thể dữ liệu trước khi triển khai chiến dịch.
Các cơ sở giáo dục thường có nhiều đơn vị tham gia tuyển sinh: phòng đào tạo, bộ phận truyền thông, khoa, trung tâm tư vấn, đại lý nền tảng và nhà cung cấp chatbot. Sự phân tán ấy dễ tạo nhiều bản sao dữ liệu, nhiều danh sách liên hệ và nhiều lời giải thích khác nhau về mục đích thu thập. Cần tránh coi việc đặt một đường dẫn tới chính sách quyền riêng tư là đã giải quyết toàn bộ vấn đề. Người dùng cần hiểu ngay tại thời điểm cung cấp dữ liệu vì sao trường cần thông tin, nội dung nào là tùy chọn và họ còn cách nhận tư vấn nào nếu không muốn được theo dõi hành vi. Nghiên cứu về phân tích dữ liệu học tập trong giáo dục đại học nhấn mạnh cơ chế đồng ý có thông tin và quyền tự chủ của người học [10]; bài học này cần được điều chỉnh cho đối tượng chưa nhập học.
Hiện chưa có dữ liệu đại diện cho toàn bộ trường đại học Việt Nam về mức độ triển khai AI trong cá nhân hóa tuyển sinh, số vụ sai sót hoặc tác động của việc dùng dữ liệu đến niềm tin. Vì vậy, không thể viết rằng "phần lớn các trường đã lạm dụng dữ liệu" hay "AI đang làm thí sinh mất niềm tin". Những tình huống mô tả ở trên là rủi ro có thể phát sinh, được lập luận từ thiết kế hệ thống và nghiên cứu liên quan. Trường cần tự kiểm kê thực trạng của mình, công bố số liệu kiểm soát phù hợp và kiểm định phản ứng của các nhóm công chúng trước khi mở rộng.
3. Giải pháp cá nhân hóa có trách nhiệm tại các trường đại học
3.1. Bắt đầu từ nhu cầu tự khai báo và quyền lựa chọn của công chúng
Nguyên tắc đầu tiên là cá nhân hóa theo câu hỏi được người học chủ động chọn, trước khi cá nhân hóa theo hồ sơ do hệ thống suy đoán. Trang tuyển sinh có thể cho phép chọn "Tôi đang tìm hiểu ngành", "Tôi muốn so sánh học phí", "Tôi chuẩn bị đăng ký", "Tôi là phụ huynh". Mỗi lựa chọn dẫn tới một bộ thông tin đã được bộ phận chuyên môn xác thực, có đường dẫn trở lại bản công bố đầy đủ. Người dùng được đổi nhóm nhu cầu bất cứ lúc nào; việc chọn một chủ đề không nên tự động giới hạn họ chỉ nhìn thấy các ngành hoặc cơ hội mà thuật toán cho là phù hợp.
Với tư vấn theo dữ liệu chủ động cung cấp, biểu mẫu nên hỏi ít trường thông tin nhất để phục vụ yêu cầu cụ thể. Ví dụ, để gửi hướng dẫn xét tuyển một ngành, cần địa chỉ liên hệ và ngành quan tâm; không mặc định yêu cầu điểm học tập, số định danh hay dữ liệu gia đình. Nếu người học muốn đánh giá cơ hội trúng tuyển, trường mới giải thích dữ liệu điểm nào cần thiết, nguồn quy tắc tính và giới hạn của kết quả. Gợi ý từ AI phải được ghi là ước tính hỗ trợ tìm hiểu, không phải quyết định xét tuyển hoặc cam kết trúng tuyển. Việc từ chối cung cấp dữ liệu tùy chọn không nên làm người học mất quyền tiếp cận thông tin tuyển sinh công khai.
3.2. Thiết kế kiến trúc dữ liệu theo mục đích và mức rủi ro
Trước khi mua công cụ, trường cần vẽ được hành trình của từng trường dữ liệu: thu thập ở đâu, phục vụ mục đích gì, lưu ở đâu, ai truy cập, chuyển cho bên nào, khi nào xóa. Có thể phân ba tầng. Tầng công khai gồm thông tin chương trình, học phí và quy chế đã phát hành; AI được phép tìm kiếm và diễn đạt lại nhưng phải dẫn nguồn. Tầng tư vấn tự nguyện gồm ngành quan tâm và câu hỏi do người dùng cung cấp; chỉ bộ phận phụ trách được truy cập cho mục đích đã thông báo. Tầng cần kiểm soát cao gồm điểm học tập, tình trạng ưu tiên, hồ sơ cá nhân và ghi chú hoàn cảnh; không đưa nguyên trạng vào dịch vụ AI bên ngoài nếu chưa hoàn tất đánh giá và kiểm soát cần thiết.
Một hệ thống tốt nên lưu thông tin ở mức tối thiểu đủ trả lời. Có thể thay tên thí sinh bằng mã phiên tư vấn khi kiểm thử chất lượng chatbot, tổng hợp xu hướng câu hỏi mà không lưu nội dung nhận diện, hoặc dùng dữ liệu giả lập để kiểm thử tính đúng của câu trả lời. Khi hợp đồng với nhà cung cấp, trường cần quy định rõ quyền dùng dữ liệu để huấn luyện, quyền truy cập của nhân viên kỹ thuật, vị trí và thời hạn lưu, nhật ký truy cập, xử lý sự cố và cách kết thúc hợp đồng. Bộ phận phụ trách bảo vệ dữ liệu và pháp chế cần tham gia ngay từ thiết kế, thay vì chỉ đọc hợp đồng khi hệ thống đã chạy. Các lựa chọn ấy cần được đối chiếu với Luật 91/2025/QH15 và Nghị định 356/2025/NĐ-CP theo tình huống cụ thể [3, 4].
3.3. Xây dựng nguồn kiến thức tuyển sinh có thể kiểm chứng cho AI
AI chỉ nên cá nhân hóa cách trình bày một thông tin tuyển sinh đã có nguồn, không tự tạo nội dung quy định. Trường cần lập kho kiến thức được duyệt: mã ngành, chương trình, học phí, học bổng, điều kiện, mốc thời gian, câu hỏi thường gặp và liên kết văn bản gốc. Mỗi mục có đơn vị chủ sở hữu, ngày hiệu lực và ngày cập nhật; khi thông tin thay đổi, hệ thống ngừng sử dụng phiên bản cũ. Mọi câu trả lời có hệ quả đối với việc nộp hồ sơ phải hiển thị nguồn và thời điểm xác nhận. Nếu không có nguồn hoặc câu hỏi đòi hỏi áp dụng ngoại lệ cá nhân, chatbot phải chuyển người tư vấn thay vì suy đoán.
Cần kiểm thử kho kiến thức bằng các câu hỏi khó: hai chương trình có mức học phí khác nhau, chính sách học bổng thay đổi theo năm, trường hợp ưu tiên hoặc phương thức xét tuyển chỉ áp dụng cho một nhóm thí sinh. Cán bộ tuyển sinh cần đánh giá câu trả lời về tính đúng, đủ, không gây hiểu nhầm và khả năng tìm lại nguồn. Bộ phận truyền thông đánh giá độ rõ ràng và giọng điệu, nhưng không tự quyết định tính hợp lệ của dữ kiện. Sau mỗi đợt cập nhật quy chế, trường phải chạy lại bộ câu hỏi chuẩn trước khi mở hệ thống. Cách tổ chức này đưa năng lực con người vào vị trí kiểm soát chất lượng, phù hợp hướng tiếp cận lấy con người làm trung tâm của UNESCO [5].
3.4. Công khai cách cá nhân hóa và bảo đảm đường tư vấn bằng con người
Giao diện nên giải thích bằng câu ngắn, đặt đúng thời điểm: "Nội dung gợi ý dựa trên ngành bạn vừa chọn"; "Bạn có thể xem tất cả ngành và tắt gợi ý"; "Câu trả lời do trợ lý AI hỗ trợ, dữ kiện lấy từ thông tin tuyển sinh cập nhật ngày…". Nếu trường dùng lịch sử tương tác để tiếp tục tư vấn, cần giải thích điều đó riêng, thay vì gộp vào một câu chấp thuận chung khó đọc. Công chúng cần có cách sửa thông tin đã cung cấp, thay đổi lựa chọn nhận liên hệ và yêu cầu nói chuyện với người thật. Đó là các đề xuất thiết kế giao tiếp; việc thực hiện quyền theo pháp luật phải căn cứ văn bản hiện hành và quy trình của trường [3, 4].
Một đường chuyển tiếp rõ ràng đặc biệt quan trọng với quyết định có hệ quả lớn. Chatbot có thể giải thích quy trình chung nhưng không nên là người xử lý duy nhất đối với khiếu nại, hồ sơ ưu tiên, sai lệch dữ liệu điểm, tư vấn hỗ trợ tài chính hay tình huống quy chế chưa dự liệu. Hệ thống cần cho người dùng biết thời gian phản hồi dự kiến, bộ phận tiếp nhận và mã theo dõi; cán bộ nhận được bản tóm tắt câu hỏi chỉ trong phạm vi dữ liệu cần thiết để giải quyết. Nếu người học phải kể lại toàn bộ hoàn cảnh nhạy cảm sau khi đã nói với AI, dịch vụ vừa bất tiện vừa làm tăng số lần dữ liệu được chia sẻ.
3.5. Kiểm tra công bằng và giới hạn của gợi ý
Cá nhân hóa có thể vô tình ưu tiên chương trình có chỉ tiêu hoặc ngân sách quảng cáo lớn hơn, thay vì chương trình phù hợp với người học. Vì vậy, thuật toán gợi ý ngành cần được kiểm tra trên các nhóm câu hỏi và nhóm người dùng khác nhau: học sinh vùng nông thôn và thành thị, người quan tâm học phí thấp, người chưa có thành tích cao, người có nhu cầu hỗ trợ tiếp cận. Kiểm tra không có nghĩa là trường phải thu thập thêm dữ liệu nhạy cảm cho mọi thí sinh; có thể dùng tình huống giả lập và đánh giá tự nguyện, tổng hợp để nhận diện sai lệch. Hệ thống cần có chức năng "xem toàn bộ lựa chọn" và giải thích tiêu chí sắp xếp.
Khi chatbot đề xuất một ngành, nên trình bày ít nhất hai loại thông tin: vì sao gợi ý phù hợp với câu hỏi người dùng đã nêu và những điều người học cần tự kiểm tra thêm, như học phí, năng lực đầu vào và đặc điểm công việc sau tốt nghiệp. Không nên gắn nhãn "ngành phù hợp nhất" nếu chưa có công cụ đánh giá được thẩm định. Người tư vấn cũng cần tránh dùng điểm số dự đoán khả năng nhập học để đối xử khác nhau với thí sinh: nhóm được dự báo ít khả năng đăng ký vẫn phải có quyền được trả lời chính xác, kịp thời. Thước đo công bằng trong tuyển sinh là tiếp cận thông tin cần thiết và cơ hội được giải đáp, không chỉ hiệu quả chuyển đổi quảng cáo.
3.6. Đo lợi ích thông tin cùng quyền riêng tư và niềm tin
Bộ chỉ số thí điểm cần vượt ra ngoài số lượng tin nhắn gửi hoặc lượt nhấp. Về lợi ích, đo khả năng tìm đúng thông tin trong thời gian ngắn, tỷ lệ hiểu đúng điều kiện tuyển sinh, tỷ lệ câu hỏi được giải đáp dứt điểm và mức hài lòng với sự phù hợp của gợi ý. Về quản trị dữ liệu, theo dõi tỷ lệ biểu mẫu chỉ thu thập dữ liệu cần thiết, số yêu cầu điều chỉnh hoặc ngừng liên hệ được xử lý đúng hạn, số người chuyển sang tư vấn bằng con người và các sự cố truy cập hoặc gửi nhầm. Về niềm tin, hỏi riêng mức tin vào tính chính xác của nội dung, sự chính trực trong sử dụng dữ liệu và thiện chí của trường khi xảy ra sai sót, theo tiếp cận quan hệ tổ chức – công chúng [6].
Trường nên thí điểm theo thiết kế có đối chứng. Một nhóm nhận hướng dẫn chung, một nhóm được tự chọn chủ đề, một nhóm được AI hỗ trợ trình bày dựa trên cùng nguồn dữ kiện đã kiểm tra; người tham gia được biết điều kiện nghiên cứu và cách dữ liệu được sử dụng. So sánh mức hiểu đúng, thời gian hoàn thành nhiệm vụ, cảm nhận hữu ích, lo ngại quyền riêng tư, mức tin vào trường và khả năng lựa chọn ngành phù hợp. Nếu chỉ tăng lượt nhấp nhưng giảm cảm nhận quyền kiểm soát hoặc tạo chênh lệch tiếp cận giữa các nhóm, cần sửa thiết kế. Các kết quả thử nghiệm của một trường không tự động khái quát cho trường khác; loại ngành, năng lực số của công chúng và mức danh tiếng sẵn có có thể thay đổi phản ứng.
Về nghiên cứu tiếp theo, có thể kiểm định một mô hình gồm mức cá nhân hóa (theo lựa chọn chủ đề, theo thông tin tự khai báo, theo hành vi suy đoán), tính hữu ích cảm nhận và quyền kiểm soát cảm nhận là các cơ chế trung gian, niềm tin vào trường là kết quả, còn mức hiểu biết AI và lo ngại quyền riêng tư là điều kiện điều tiết. Cần đo riêng niềm tin vào chatbot, niềm tin vào nội dung và niềm tin đối với cơ sở giáo dục. Thí sinh, phụ huynh và sinh viên hiện tại nên được phân tích riêng; khảo sát cắt ngang chỉ chỉ ra liên hệ, còn tác động của cách cá nhân hóa cần thử nghiệm ngẫu nhiên hoặc theo dõi theo thời gian. Đây là hướng nối nghiên cứu truyền thông số trước đây với đề tài AI và niềm tin mà không gán kết quả cũ cho công nghệ mới.
Cá nhân hóa trong tuyển sinh chỉ có giá trị bền vững khi người học nhận được thông tin đúng nhu cầu mà vẫn biết mình đang chia sẻ điều gì, với ai và có thể chọn cách tiếp cận khác. Quy mô xét tuyển, dữ liệu hành vi truyền thông số và khung pháp lý mới cùng làm cho bài toán này trở nên cấp thiết. Trường đại học có thể bắt đầu bằng nhu cầu tự khai báo, nguồn dữ kiện chuẩn, thu thập tối thiểu, kiểm duyệt của con người và đường tư vấn rõ ràng; sau đó mới xem xét các cấp độ dự đoán phức tạp. Hiệu quả cần được đánh giá đồng thời ở tính hữu ích, công bằng, quyền riêng tư và niềm tin. Đây là trách nhiệm quản trị quan hệ với công chúng, không chỉ là một quyết định chọn công cụ AI.
Tài liệu tham khảo
1. Trần Quang Hà (2026), Ảnh hưởng của truyền thông trên nền tảng số đến quyết định chọn trường của sinh viên đại học khối ngành kỹ thuật – công nghệ tại Việt Nam, luận văn thạc sĩ, Học viện Báo chí và Tuyên truyền, bản tác giả cung cấp.
2. Báo Điện tử Chính phủ (2025), "Gần 850 nghìn thí sinh đăng ký xét tuyển đại học, cao đẳng năm 2025", 28/7/2025. https://baochinhphu.vn/gan-850-nghin-thi-sinh-dang-ky-xet-tuyen-dai-hoc-cao-dang-nam-2025-102250728202611296.htm
3. Quốc hội (2025), Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, ngày 26/6/2025. https://vanban.chinhphu.vn/?classid=1&docid=214590&orggroupid=1&pageid=27160
4. Chính phủ (2025), Nghị định số 356/2025/NĐ-CP ngày 31/12/2025 quy định chi tiết một số điều và biện pháp thi hành Luật Bảo vệ dữ liệu cá nhân. https://vanban.chinhphu.vn/?docid=216387&pageid=27160
5. Miao, F. & Holmes, W. (2023), Guidance for generative AI in education and research, UNESCO. https://www.unesco.org/en/articles/guidance-generative-ai-education-and-research
6. Hon, L. C. & Grunig, J. E. (1999), Guidelines for Measuring Relationships in Public Relations, Institute for Public Relations. https://instituteforpr.org/measuring-relationships/
7. Lefkeli, D., Karataş, M. & Gürhan-Canli, Z. (2024), "Sharing information with AI (versus a human) impairs brand trust: The role of audience size inferences and sense of exploitation", International Journal of Research in Marketing, 41(1), 138–155. https://doi.org/10.1016/j.ijresmar.2023.08.011
8. Teepapal, T. (2025), "AI-driven personalization: Unraveling consumer perceptions in social media engagement", Computers in Human Behavior, 165, 108549. https://doi.org/10.1016/j.chb.2024.108549
9. An, G. K. & Ngo, T. T. A. (2025), "AI-powered personalized advertising and purchase intention in Vietnam's digital landscape: The role of trust, relevance, and usefulness", Journal of Open Innovation: Technology, Market, and Complexity, 11(3), 100580. https://doi.org/10.1016/j.joitmc.2025.100580
10. Jones, K. M. L. (2019), "Learning analytics and higher education: a proposed model for establishing informed consent mechanisms to promote student privacy and autonomy", International Journal of Educational Technology in Higher Education, 16, 24. https://doi.org/10.1186/s41239-019-0155-0
Trần Quang Hà
Trường Đại học Điện lực