Nghị quyết số 57-NQ/TW, ngày 22/12/2024 của Bộ Chính trị về đột phá phát triển khoa học, công nghệ, đổi mới sáng tạo và chuyển đổi số quốc gia và Đại hội XIV của Đảng đều xác định khoa học, công nghệ, đổi mới sáng tạo và chuyển đổi số là động lực trung tâm của phát triển. Trong giáo dục, đào tạo, chuyển đổi số không chỉ dừng ở số hóa bài giảng, học liệu mà còn bao gồm việc hiện đại hóa công tác quản trị, trong đó có quản lý và khai thác hệ thống văn bản nội bộ.
TS. Hoảng Minh Tuấn - Phó giám đốc phụ trách Học viện Thanh thiếu niên Việt Nam, TS. Nguyễn Quang Trung - Trưởng khoa Khoa Công nghệ và Ngoại ngữ, Học viện Thanh thiếu niên Việt Nam chụp ảnh lưu niệm với giảng viên trẻ Khoa công nghệ và Ngoại ngữ Học viện.
Tại Học viện Thanh thiếu niên Việt Nam, khối lượng quy chế, quyết định, hướng dẫn nghiệp vụ cần được cán bộ, giảng viên, sinh viên tra cứu thường xuyên là rất lớn. Văn bản có cấu trúc phân cấp theo Điều, Khoản, Điểm, xen kẽ nhiều bảng biểu quy định mức chi, định mức giờ, thường xuyên được sửa đổi, bổ sung; không ít văn bản được lưu trữ dưới dạng bản quét. Việc tra cứu thủ công bằng cách mở từng tệp, tìm theo từ khóa tốn nhiều thời gian, dễ bỏ sót thông tin. Bài viết trình bày cơ sở khoa học, thiết kế, kết quả thực nghiệm và đề xuất giải pháp triển khai hệ thống chatbot cho phép người dùng đặt câu hỏi bằng ngôn ngữ tự nhiên và nhận câu trả lời chính xác, có trích dẫn nguồn, tổng hợp từ kho tài liệu nội bộ đã được số hóa.
CƠ SỞ KHOA HỌC VÀ LỰA CHỌN PHƯƠNG PHÁP
Căn cứ vào cơ chế sinh câu trả lời, chatbot được chia thành bốn nhóm: dựa trên luật, dựa trên truy xuất, sinh tạo và kết hợp. Nhóm dựa trên truy xuất bảo đảm tính chính xác nhưng không tạo được câu trả lời mới; nhóm sinh tạo linh hoạt nhưng khó kiểm soát nội dung; nhóm kết hợp cân bằng được hai ưu điểm trên. Nền tảng của các chatbot sinh tạo hiện nay là mô hình ngôn ngữ lớn (Large Language Model – LLM) - mô hình học sâu dựa trên kiến trúc Transformer, được huấn luyện trên khối lượng văn bản khổng lồ, có khả năng hiểu ngữ cảnh, suy luận và sinh ngôn ngữ tự nhiên. Tuy nhiên, khi ứng dụng vào tra cứu văn bản nội bộ, LLM tổng quát có ba hạn chế: không có tri thức về văn bản nội bộ do các văn bản này không nằm trong dữ liệu huấn luyện; có thể xảy ra hiện tượng "ảo giác" (sinh câu trả lời trôi chảy nhưng sai sự thật) - điều không thể chấp nhận với văn bản có giá trị pháp lý; và việc gửi dữ liệu tới máy chủ bên ngoài không bảo đảm an toàn thông tin.
Có ba hướng khắc phục. Huấn luyện lại mô hình từ đầu đòi hỏi hàng trăm tỷ token dữ liệu, hàng trăm GPU và chi phí hàng triệu USD, không khả thi với một cơ sở giáo dục có khối lượng tài liệu ở mức vài trăm đến vài nghìn trang. Tinh chỉnh (fine-tune) mô hình có sẵn, kể cả bằng kỹ thuật tiết kiệm tham số như LoRA, rẻ hơn nhưng cần xây dựng thủ công tập câu hỏi - câu trả lời, phải huấn luyện lại mỗi khi văn bản thay đổi, có nguy cơ làm suy giảm năng lực tổng quát của mô hình và khó truy vết nguồn câu trả lời. Phương pháp RAG (Retrieval-Augmented Generation) do Lewis và cộng sự giới thiệu năm 2020 cho phép mô hình tra cứu thông tin từ kho tài liệu bên ngoài tại thời điểm trả lời. Cơ chế RAG gồm hai giai đoạn (Hình 1): giai đoạn lập chỉ mục, văn bản được chia thành các đoạn nhỏ (chunking), chuyển thành vector ngữ nghĩa bằng mô hình embedding và lưu vào cơ sở dữ liệu vector; giai đoạn truy vấn, câu hỏi được chuyển thành vector để tìm các đoạn văn bản gần nhất về ngữ nghĩa, rồi đưa cùng câu hỏi vào LLM để sinh câu trả lời kèm nguồn trích dẫn.
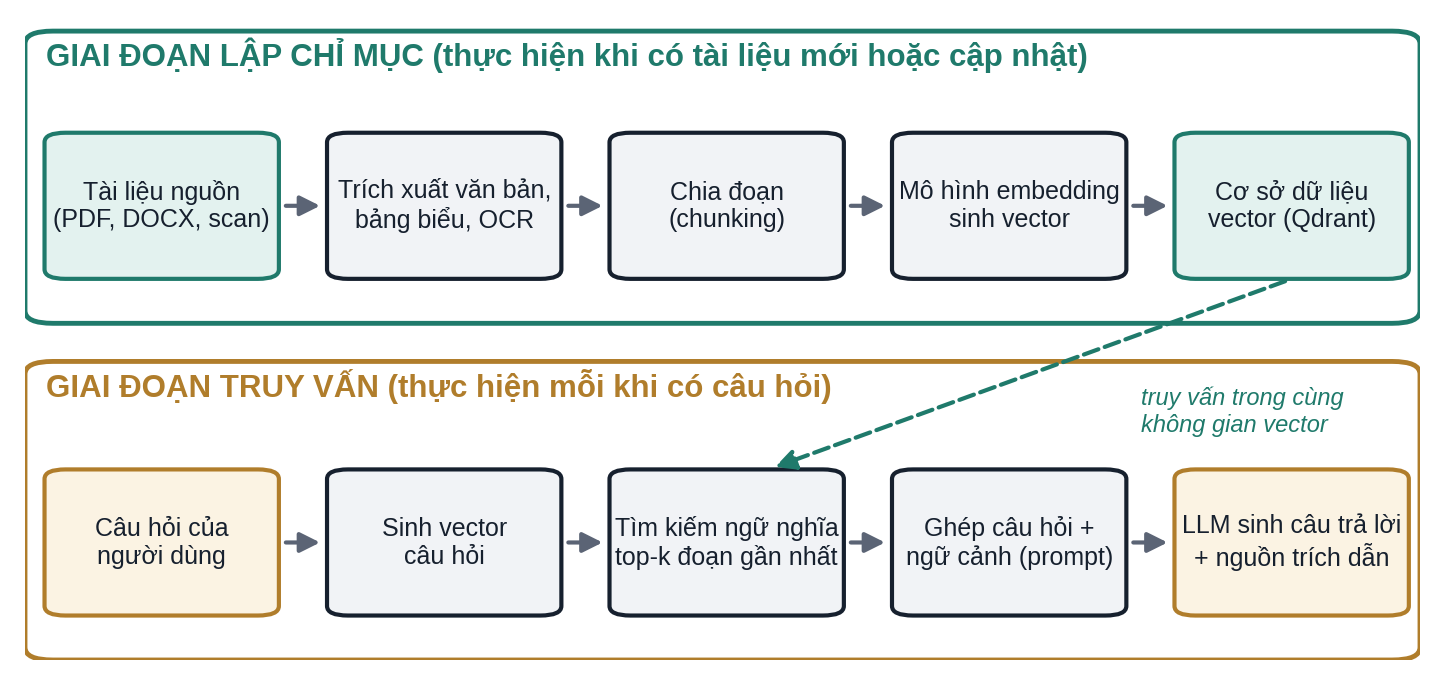
Cơ chế hoạt động của phương pháp RAG
RAG không cần huấn luyện lại khi văn bản thay đổi, truy vết được nguồn tới tên tài liệu và số trang, có chi phí thấp và giảm thiểu hiện tượng ảo giác. Vì vậy, RAG được lựa chọn làm phương pháp cốt lõi của hệ thống.
THIẾT KẾ HỆ THỐNG
Hệ thống phục vụ bốn nhóm đối tượng với quyền hạn khác nhau: quản trị viên quản lý kho tài liệu, cấu hình mô hình và phân quyền; giảng viên được tải tài liệu lên các kho được giao và tra cứu; sinh viên tra cứu các kho được cấp quyền, xem lại lịch sử hội thoại; khách vãng lai không cần tài khoản, tra cứu các kho công khai qua cửa sổ chat nhúng trên website Học viện. Tương ứng, hệ thống có ba giao diện: giao diện quản trị, cổng thông tin (Portal) cho giảng viên, sinh viên và widget chat cho khách vãng lai. Kiến trúc hệ thống gồm bốn lớp: lớp giao diện; lớp API và bảo mật; lớp dịch vụ lõi (quản lý kho tài liệu, chia đoạn, RAG, đánh giá cấu hình); lớp dữ liệu và mô hình (PostgreSQL, Qdrant, Redis, vLLM).
Mô hình được lựa chọn là Qwen2.5-7B-Instruct (bản lượng tử hóa AWQ), tự triển khai trên GPU 24GB của Học viện thông qua công cụ vLLM, vì hỗ trợ tiếng Việt tốt trong nhóm mô hình mã nguồn mở, phù hợp với phần cứng phổ thông và bảo đảm dữ liệu không rời khỏi hạ tầng nội bộ. Quá trình thiết kế tuân thủ các nguyên tắc: mỗi kho tài liệu có một collection vector riêng để tránh xung đột và thu hẹp phạm vi tìm kiếm; mọi lời gọi tới mô hình đều có hàng đợi và giới hạn thời gian để hệ thống không bị treo khi quá tải; bộ nhớ đệm Redis giúp trả lời ngay các câu hỏi lặp lại; phân quyền theo vai trò kết hợp phân quyền theo từng kho tài liệu.
Đối với xử lý tài liệu, bước tải lên và bước chia đoạn được tách rời, cho phép quản trị viên chủ động thời điểm xử lý, lựa chọn chế độ tự động hoặc xuất các đoạn văn bản ra tệp để chỉnh sửa thủ công rồi nạp lại. Hệ thống tự động nhận dạng ký tự quang học (OCR) với văn bản dạng ảnh quét, chuyển bảng biểu sang định dạng Markdown giữ nguyên cấu trúc hàng, cột và lưu số trang gốc để trích dẫn. Khi một đoạn văn bản được sửa, hệ thống chỉ sinh lại vector cho đúng đoạn đó, không phải xử lý lại toàn bộ tài liệu.
THỰC NGHIỆM VÀ ĐÁNH GIÁ
Dữ liệu thực nghiệm là các văn bản hành chính của Học viện: Quy chế chi tiêu nội bộ (PDF, nhiều bảng biểu), Quy định chế độ làm việc đối với giảng viên (PDF) và Hướng dẫn nghiệp vụ công tác Đảng (DOCX). Đây là văn bản tiếng Việt có câu dài, nhiều mệnh đề, nhiều thuật ngữ và từ viết tắt, cấu trúc theo Điều, Khoản, Điểm; một số văn bản được số hóa bằng máy quét. Hệ thống được triển khai trên máy trạm một GPU 24GB, sử dụng các mô hình embedding multilingual-e5-small, BAAI/bge-m3 và vietnamese-sbert.
Hệ thống tích hợp mô-đun Evaluation Lab để so sánh các tổ hợp chiến lược chia đoạn và mô hình embedding trên cùng bộ câu hỏi mẫu, theo các chỉ số: tỷ lệ truy xuất trúng tài liệu kỳ vọng trong top-k kết quả (hit rate), tỷ lệ câu trả lời chứa đúng từ khóa kỳ vọng và độ trễ phản hồi. Dữ liệu thử nghiệm được tạo tạm thời và xóa sau khi đánh giá, không ảnh hưởng tới hệ thống đang vận hành. Kết quả so sánh các chiến lược chia đoạn được tổng hợp tại Bảng 1.
Bảng 1. Kết quả đánh giá các chiến lược chia đoạn văn bản
Chiến lược | Nhận xét qua thực nghiệm |
|---|---|
Độ dài cố định | Nhanh nhất nhưng thường xuyên cắt ngang câu, giảm chất lượng ngữ nghĩa. |
Đệ quy (recursive) | Ưu tiên cắt tại ranh giới đoạn, câu; phù hợp làm mặc định cho đa số tài liệu. |
Theo câu tiếng Việt | Tốt nhất với văn bản hành chính: giữ trọn ngữ nghĩa từng Điều, Khoản, cải thiện rõ rệt độ chính xác truy xuất. |
Theo đoạn văn | Kém hiệu quả với văn bản nhiều đoạn liệt kê ngắn xen bảng biểu. |
Theo ngữ nghĩa (semantic) | Chất lượng cao nhưng xử lý chậm; dùng chọn lọc cho tài liệu phức tạp. |
Nguồn: Kết quả thực nghiệm của nhóm tác giả.
Nguyên nhân chủ yếu nằm ở đặc thù câu văn hành chính tiếng Việt: câu dài, nhiều mệnh đề nên cách cắt theo độ dài cố định dễ tách một quy định thành nhiều mảnh rời rạc, trong khi chia theo câu bảo toàn được đơn vị ngữ nghĩa trọn vẹn. Do đó, chiến lược chia theo câu tiếng Việt được khuyến nghị làm mặc định cho phần lớn kho tài liệu hành chính; chiến lược theo ngữ nghĩa được dùng chọn lọc cho tài liệu phức tạp vì chỉ chạy một lần khi tải lên, không ảnh hưởng tốc độ trả lời.
Quá trình thực nghiệm còn giúp phát hiện và khắc phục một số vấn đề phát sinh với dữ liệu thực tế: bảng biểu không trích xuất được được xử lý bằng thư viện chuyên dụng; xung đột kích thước vector khi nhiều kho dùng chung một collection được khắc phục bằng cách tách riêng từng kho kèm giới hạn thời gian cho mọi thao tác; tên tệp tiếng Việt có dấu bị lỗi khi tải về được xử lý theo chuẩn mã hóa RFC 5987; nhật ký xử lý theo thời gian thực được bổ sung để theo dõi tiến trình và xác định nguyên nhân lỗi.
GIẢI PHÁP TRIỂN KHAI HỆ THỐNG TẠI HỌC VIỆN
Một là, triển khai theo lộ trình từ thí điểm đến vận hành chính thức. Giai đoạn 1 (tháng 1–2) thí điểm nội bộ với 3–5 kho tài liệu ưu tiên như quy chế tài chính, quy định lao động, quy chế đào tạo, kết hợp đánh giá để xác định cấu hình tối ưu; giai đoạn 2 (tháng 3–4) mở rộng cho giảng viên, sinh viên, tổ chức tập huấn và thu thập phản hồi; giai đoạn 3 (tháng 5) công khai qua website Học viện đối với thông tin tuyển sinh, quy định chung; giai đoạn 4 (từ tháng 6) vận hành chính thức, đánh giá định kỳ hằng quý.
Hai là, chuẩn hóa quy trình số hóa và cập nhật kho tài liệu. Chất lượng câu trả lời phụ thuộc trực tiếp vào chất lượng kho tài liệu, vì vậy cần gắn trách nhiệm cập nhật cho từng đơn vị chủ quản văn bản; kịp thời loại bỏ văn bản hết hiệu lực, bổ sung văn bản mới; kiểm tra, chỉnh sửa thủ công đối với tài liệu quan trọng hoặc được số hóa từ bản quét.
Ba là, bảo đảm hạ tầng và an toàn thông tin. Cấu hình một GPU 24GB đáp ứng quy mô vài trăm người dùng trong giai đoạn thí điểm; khi công khai trên website cần cân nhắc đầu tư máy chủ chuyên dụng hoặc dịch vụ GPU đám mây để bảo đảm khả năng phục vụ đồng thời. Mức độ hiển thị nguồn trích dẫn cho khách vãng lai cần phù hợp với chính sách bảo mật thông tin của Học viện.
Bốn là, tiếp tục hoàn thiện hệ thống: tinh chỉnh mô hình embedding cho văn phong hành chính, đánh giá tự động bằng LLM (LLM-as-judge), tích hợp đăng nhập một lần (SSO), hỗ trợ hội thoại nhiều lượt, mở rộng qua Zalo, Telegram.
Tóm lại: Hệ thống chatbot tra cứu tài liệu nội bộ ứng dụng mô hình ngôn ngữ lớn và phương pháp RAG đã được xây dựng và thử nghiệm thành công trên dữ liệu thực tế của Học viện Thanh thiếu niên Việt Nam, đáp ứng các yêu cầu: quản lý đa kho tài liệu, hỗ trợ nhiều chiến lược chia đoạn tối ưu cho tiếng Việt, phân quyền chi tiết, đánh giá cấu hình định lượng; câu trả lời có nguồn trích dẫn và dữ liệu được xử lý trên hạ tầng nội bộ. Hệ thống còn một số hạn chế như chỉ số đánh giá theo từ khóa mới mang tính tương đối, vận hành trên một GPU có thể phát sinh hàng đợi khi tải cao, chưa tích hợp xác thực tập trung. Kết quả nghiên cứu cho thấy, với phương pháp phù hợp và hạ tầng phổ thông, các cơ sở giáo dục hoàn toàn có thể chủ động ứng dụng trí tuệ nhân tạo vào công tác quản trị, góp phần thực hiện thắng lợi mục tiêu chuyển đổi số trong giai đoạn mới./.
TS. Nguyễn Quang Trung, Ths. Nguyễn Văn Pha,Ths. Phùng Thị Ngọc Thúy
Khoa Công nghệ và Ngoại ngữ, Học viện Thanh thiếu niên Việt Nam
-----------------------------------------------------------
TÀI LIỆU THAM KHẢO:
1. Đảng Cộng sản Việt Nam (2026), Văn kiện Đại hội đại biểu toàn quốc lần thứ XIV của Đảng, Hà Nội.
2. Bộ Chính trị (2024), Nghị quyết số 57-NQ/TW, ngày 22/12/2024 về đột phá phát triển khoa học, công nghệ, đổi mới sáng tạo và chuyển đổi số quốc gia, Hà Nội.
3. Khoa Công nghệ thông tin, Học viện Thanh thiếu niên Việt Nam, Báo cáo đề tài "Xây dựng hệ thống chatbot tra cứu tài liệu nội bộ ứng dụng mô hình ngôn ngữ lớn và phương pháp RAG tại Học viện Thanh thiếu niên Việt Nam", Hà Nội.
4. Lewis, P. et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 33.
5. Qwen Team (2024), Qwen2.5 Technical Report, arXiv:2412.15115…