Bộ dữ liệu mới gồm 1 triệu, gấp 10 lần phiên bản trước, mang đến cho các nhà phát triển, nhà nghiên cứu và doanh nghiệp một nền tảng lớn hơn, có tính đại diện cao hơn để xây dựng mô hình, tác tử và ứng dụng có khả năng thấu hiểu con người, ngôn ngữ và văn hóa Việt Nam.
Được FPT ra mắt lần đầu vào tháng 6/2026 với sự hợp tác của NVIDIA, Nemotron-Personas-Vietnam là bộ dữ liệu mở gồm các chân dung người dùng tổng hợp, được xây dựng dựa trên số liệu thống kê chính thức của Việt Nam từ Tổng cục Thống kê (GSO), bao gồm Tổng điều tra dân số và nhà ở năm 2024, Khảo sát mức sống dân cư Việt Nam (VHLSS) năm 2024, cùng nguồn dữ liệu từ FPT Smart Cloud và Viện Quantum AI & Cyber Security (Tập đoàn FPT).
Mỗi chân dung được mô tả qua 21 trường dữ liệu, gồm 6 trường thông tin chân dung và 15 trường thông tin bối cảnh, bao phủ các thuộc tính cá nhân và nhân khẩu học. Bộ dữ liệu đồng thời bao gồm 13.000 tổ hợp họ tên đầy đủ độc nhất và 20 nhóm nghề nghiệp được xây dựng từ dữ liệu khảo sát lao động.
Nemotron-Personas-Vietnam được phát triển dựa trên phương pháp luận Nemotron-Personas của NVIDIA, trong đó quy trình tạo chân dung được dựa trên dữ liệu thống kê thực tế và các mô hình ngôn ngữ lớn trọng số mở được sử dụng để xây dựng những mô tả có độ chân thực cao. Nhờ đó, bộ dữ liệu cung cấp các chân dung người dùng Việt Nam tổng hợp đa dạng về độ tuổi, khu vực, nghề nghiệp, thu nhập, trình độ học vấn và bối cảnh văn hóa, đồng thời không chứa bất kỳ thông tin định danh cá nhân (PII) nào.
Bộ dữ liệu hiểu Việt Nam ở quy mô lớn
Đợt mở rộng này không chỉ đơn thuần gia tăng quy mô dữ liệu. Việc nâng số lượng lên 1 triệu chân dung giúp mở ra những phương thức mới để các nhà phát triển xây dựng, huấn luyện và đánh giá các giải pháp AI phục vụ người dùng Việt Nam.
Với số lượng chân dung lớn hơn, nhà phát triển có thể lựa chọn và phân tích những nhóm người dùng cụ thể hơn, chẳng hạn người đã nghỉ hưu tại Thành phố Hồ Chí Minh, nông hộ quy mô nhỏ ở Đồng bằng sông Cửu Long hay kỹ sư trẻ tại Đà Nẵng, với số lượng dữ liệu đủ lớn để phục vụ huấn luyện và kiểm thử một cách tin cậy. Ở phiên bản này, mức độ bao phủ sâu rộng hơn trong khi phiên bản trước chỉ lấy mẫu tại một số tỉnh và thành phố lớn. Phiên bản gồm 1.000.000 chân dung trên toàn quốc, giúp các nhà phát triển xây dựng và kiểm thử sản phẩm dành cho người dùng ở mọi vùng miền.
Quy mô mở rộng cũng hỗ trợ các đợt huấn luyện lớn hơn, hoạt động kiểm thử đối kháng (red-teaming) toàn diện hơn và các mô phỏng ở cấp độ dân số mà phiên bản ban đầu chưa thể đáp ứng độc lập.
Đồng thời, sự đa dạng cao hơn về bối cảnh, kỹ năng và hành vi giúp hạn chế việc các mô hình huấn luyện trên dữ liệu tổng hợp dần phụ thuộc vào một số khuôn mẫu lặp lại. Đây là vấn đề ngày càng được quan tâm khi dữ liệu tổng hợp giữ vai trò cốt lõi trong các quy trình AI.
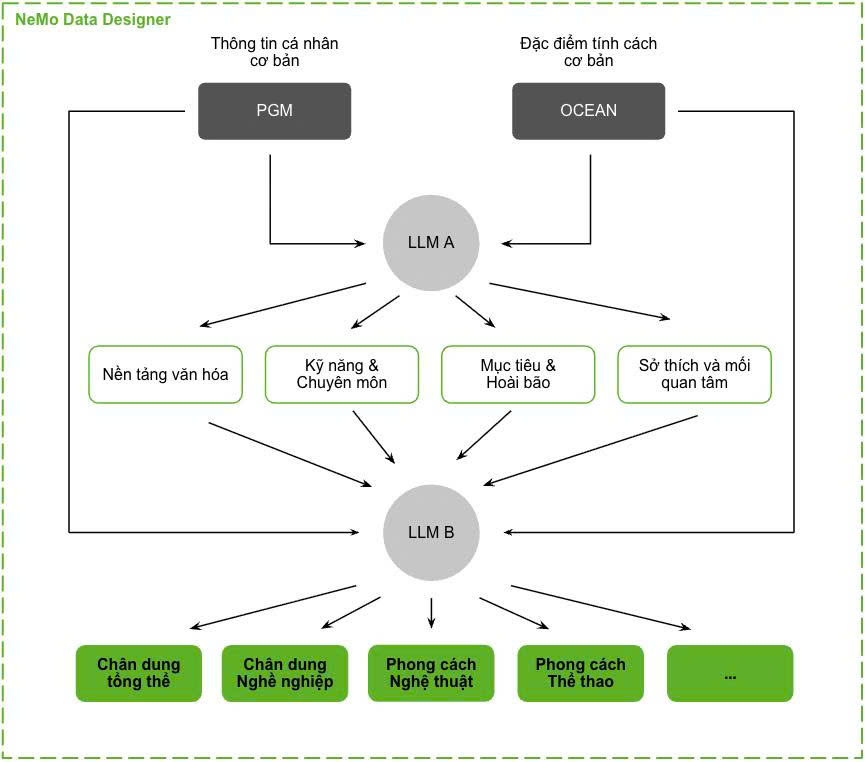
Hệ thống AI kết hợp để tạo personas tổng hợp dựa trên phân bố thực tế của Việt Nam (Ảnh: huggingface.co)
Toàn bộ dữ liệu trong Nemotron-Personas-Vietnam là dữ liệu tổng hợp, không chứa thông tin định danh cá nhân. Bộ dữ liệu được phát hành mở trên Hugging Face theo giấy phép sử dụng linh hoạt và tương thích với các thư viện NVIDIA NeMo.
Cam kết với AI có chủ quyền của Việt Nam
Việc tiếp tục mở rộng Nemotron-Personas-Vietnam sau lần công bố đầu tiên cho thấy bộ dữ liệu đang được FPT và NVIDIA duy trì, đầu tư và phát triển như một nguồn lực dài hạn cho cộng đồng AI.
Với FPT, đây là tuyên bố rõ ràng về cam kết dài hạn. Việt Nam đang đẩy nhanh quá trình chuyển đổi số. Theo Chương trình phát triển kinh tế số và xã hội số giai đoạn 2026-2030 mới được phê duyệt, Chính phủ đặt mục tiêu kinh tế số đạt khoảng 30% GDP vào năm 2030. Trong các lĩnh vực ngân hàng, tài chính, y tế, bảo hiểm, bán lẻ và dịch vụ công, các tổ chức ngày càng cần dữ liệu chân dung thực tế để kiểm thử sản phẩm, cá nhân hóa dịch vụ, mô phỏng và đánh giá mô hình AI. Bằng việc tiếp tục mở rộng bộ dữ liệu, FPT đang xây dựng lớp dữ liệu nền tảng cho AI chủ quyền của Việt Nam, một nền AI được đặt trên chính dân số, ngôn ngữ và giá trị của đất nước, thay vì phụ thuộc vào dữ liệu từ bên ngoài.
Thúc đẩy năng lực Agentic AI trong thực tiễn
Khi Agentic AI nổi lên như một hướng phát triển tiếp theo, với các hệ thống có khả năng suy luận, hành động và phục vụ từng nhóm người dùng cụ thể thay vì chỉ phản hồi thông tin. Điều này làm gia tăng nhu cầu về các nguồn dữ liệu có khả năng phản ánh thực tế đặc điểm và bối cảnh đa dạng của người dùng. Một bộ dữ liệu chân dung lớn hơn và đại diện hơn sẽ tạo nền tảng để cộng đồng AI Việt Nam xây dựng các tác tử thực sự hiểu người dùng mà hệ thống phục vụ.
Trong dịch vụ khách hàng, các doanh nghiệp có thể sử dụng những persona khác nhau về mức thu nhập, khu vực và mức độ hiểu biết tài chính để điều chỉnh giọng điệu, khuyến nghị sản phẩm và cách xử lý yêu cầu tuân thủ phù hợp với từng đối tượng, chẳng hạn người về hưu tại Hà Nội hoặc chuyên gia trẻ tại Thành phố Hồ Chí Minh.
Bộ dữ liệu cũng có thể được sử dụng để mô phỏng và đánh giá các hệ thống AI Agent, thông qua việc xây dựng những môi trường mô phỏng với nhiều nhóm người dùng và tổ chức Việt Nam có tính thực tế, triển khai kiểm thử đối kháng, đánh giá thiên lệch và tính công bằng trên nhiều nhóm nhân khẩu học; đồng thời kiểm thử khả năng vận hành của AI Agent theo khu vực, độ tuổi và nghề nghiệp mà không cần sử dụng dữ liệu khách hàng thực tế.
Với các lĩnh vực có yêu cầu quản lý và tuân thủ cao như tài chính, y tế, bảo hiểm và dịch vụ công, Nemotron-Personas-Vietnam còn có thể hỗ trợ phát triển và đánh giá AI Agent chuyên biệt theo từng lĩnh vực, nơi hệ thống cần hiểu rõ người dùng đang được hỗ trợ. Một trợ lý AI y tế có thể được đánh giá trên các chân dung bệnh nhân khác nhau về trình độ hiểu biết, khu vực và bối cảnh chăm sóc. Một trợ lý AI dịch vụ công có thể được kiểm thử với các chân dung công dân trên toàn bộ hệ thống hành chính của Việt Nam.
Tải miễn phí bộ dữ liệu trên Hugging Face .
Quang Vũ